멀티 에이전트 AI 문제점은 결국 하나로 모여요. 에이전트 하나하나의 지능이 아니라, 에이전트들 사이의 ‘조율’에서 터진다는 것. 해커뉴스에서 멀티 에이전트 실패담이 올라올 때마다 반복되는 패턴도 컨텍스트 단절, 중복 작업, 서로 덮어쓰기 이 세 가지로 수렴하거든요.
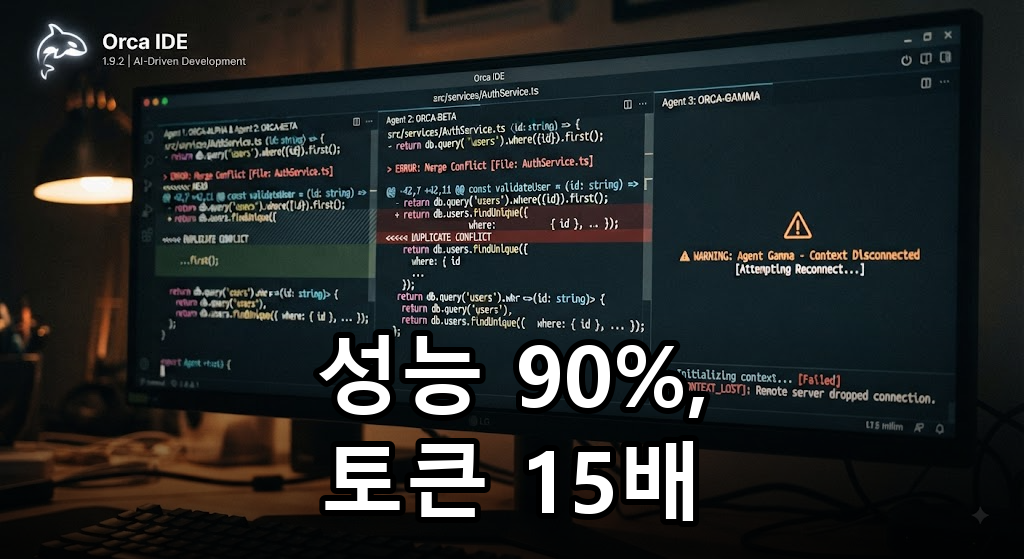
저는 오르카(Orca) IDE에서 에이전트 여러 개를 나란히 띄워 블로그 자동화 프로젝트를 굴려 왔어요. 그 과정에서 위 함정을 거의 다 밟아봤고요. 그래서 몇 개까지가 적정선인지, 비용은 정말 얼마나 더 드는지, 겪은 대로 정리해 봤어요.
멀티 에이전트 AI 문제점, 왜 에이전트가 늘수록 결과가 나빠질까요?
병목은 모델의 지능이 아니라 에이전트 간 정보 공유예요. 에이전트 A가 내린 결정을 B는 모르고, B가 고친 코드를 C는 못 본 채 각자 일해요. 전화 게임과 비슷해요. 사람이 늘수록 메시지가 왜곡되듯, 에이전트가 늘수록 맥락이 조금씩 새어 나가요.
데빈(Devin)을 만든 Cognition이 2025년에 올린 ‘Don’t Build Multi-Agents’라는 글이 이 지점을 정확히 짚어요. 하위 에이전트들이 서로의 작업 맥락을 모른 채 움직이면 결정이 충돌하고, 시스템 전체가 취약해진다는 내용이에요. 요약본만 넘기지 말고 전체 작업 흔적을 공유하라는 게 핵심 주장인데, 직접 돌려보면 이 말이 뼈에 와닿아요. 참고로 Cognition은 이후 ‘동작하는 패턴을 찾았다’며 입장을 다듬었지만, 쓰기 작업은 한 줄기로 유지하라는 전제는 그대로예요.
같은 파일을 두 에이전트가 건드릴 때 생기는 일
작업 공간을 격리하지 않고 병렬로 돌리면 덮어쓰기 사고가 나요. 저도 초반에 오르카 ai에서 에이전트 두 개에게 같은 프로젝트 폴더를 맡겼다가, 한쪽이 리팩토링한 파일을 다른 쪽이 옛 버전 기준으로 다시 고쳐놓은 걸 발견했어요. 테스트는 통과했는데 코드는 뒤죽박죽. 원인을 찾는 데 쓴 시간이 병렬로 아낀 시간보다 길었어요.
그 뒤로는 orca ide에서 워크트리(worktree) 단위로 작업 공간을 쪼개서 줘요. 에이전트마다 자기만의 격리된 복사본에서 일하고, 끝나면 제가 결과를 보고 합치는 방식이에요. 충돌은 합치는 시점 한 곳으로 모이고, 적어도 모르고 덮어쓰는 사고는 사라졌어요.
오케스트레이터가 병목이 되는 순간은 언제일까요?
조율자 에이전트 하나가 하위 결과를 전부 받아 취합하는 구조에서는, 그 조율자의 컨텍스트가 먼저 넘쳐요. 하위 에이전트 다섯이 각자 보고서를 올리면 조율자는 다섯 배의 텍스트를 읽고 판단해야 하거든요. 어느 순간부터는 실제 작업 40에 조율 비용 60이 되는 역전이 일어나요.
이 구간에 들어서면 에이전트를 더 붙이는 게 오히려 손해예요. 저는 하위 결과를 원문 그대로 넘기지 않고, 각 에이전트에게 산출물 형식을 미리 정해주는 쪽으로 바꿨어요. 파일 목록과 핵심 함수만 반환하라는 식으로요. 조율자가 읽을 양이 줄면 병목도 늦게 와요.
비용은 얼마나 더 들까요 — 토큰이 배로 나가는 구조
멀티 에이전트는 구조적으로 토큰을 많이 써요. Anthropic이 2025년 6월 공개한 멀티 에이전트 리서치 시스템 회고에 실측 수치가 있어요. 일반 채팅 대비 단일 에이전트는 약 4배, 멀티 에이전트는 약 15배의 토큰을 쓴다고 해요. 커피 한 잔 값이 점심 한 끼 값이 되는 차이예요.
이유는 단순해요. 같은 배경 지식을 에이전트마다 처음부터 다시 읽거든요. 프로젝트 구조, 코딩 컨벤션, 이전 결정 사항을 다섯 에이전트가 다섯 번 로딩해요. 다만 같은 회고에 반대편 수치도 있어요. 멀티 에이전트가 단일 에이전트(Claude Opus 4)보다 내부 리서치 평가에서 90.2% 더 잘 풀었다는 결과예요. 그래서 결론은 ‘쓰지 마라’가 아니에요. 15배의 비용을 정당화할 만한 일에만 쓰라는 거예요.
그래서 멀티 에이전트는 언제 쓰는 게 맞을까요?
판단 기준은 작업 간 의존성이에요. 서로 결과를 기다릴 필요가 없는 일은 병렬이 이기고, 앞 결과가 뒤 작업의 입력이 되는 일은 단일 에이전트가 이겨요.
| 구분 | 병렬에 맞는 일 | 병렬에 안 맞는 일 |
|---|---|---|
| 성격 | 독립적 탐색·조사·검토 | 순차 의존이 강한 구현 |
| 예시 | 코드베이스 넓게 훑기, 문서 리서치, 관점별 리뷰 | 설계→구현→테스트로 이어지는 기능 개발 |
| 실패 시 | 한 갈래만 버리면 됨 | 중간 충돌이 전체를 오염 |
| 비용 대비 | 시간 단축이 토큰 비용을 상쇄 | 토큰만 더 쓰고 품질은 하락 |
Anthropic도 같은 글에서 코딩은 리서치보다 병렬화하기 어려운 영역이라고 인정했어요. 제 경험도 같아요. 조사와 리뷰는 여러 갈래로 흩어 보내고, 실제 구현은 한 에이전트에게 맥락을 몰아주는 편이 결과가 좋았어요. 물론 프로젝트 성격에 따라 경계선은 조금씩 다를 수 있고요.
함정을 피하는 실전 체크리스트
오르카에서 시행착오 끝에 정착한 습관이에요. 멀티 에이전트를 돌리기 전에 한 번 훑어보면 좋아요.
- 작업 공간 격리: 에이전트마다 워크트리나 별도 브랜치를 줘요. 같은 파일을 두 에이전트가 만지는 순간 사고 확률이 확 올라요.
- 산출물 명세: 각 에이전트에게 무엇을 어떤 형식으로 반환할지 하나씩 정해줘요. “코드 좀 봐줘”가 아니라 “이 함수의 호출자 목록을 파일 경로와 함께 반환해줘”처럼요.
- 합성 후 시작: 탐색 결과를 짧게 요약해 합친 다음에 구현을 시작해요. 요약 없이 원문을 다 넘기면 조율자가 먼저 터져요.
- 개수 제한: 동시 실행은 2~3개에서 시작해 보세요. 늘리는 건 쉽지만, 꼬인 결과를 푸는 건 어렵거든요.
- 비용 점검: 이 작업이 토큰 15배를 낼 가치가 있는지 먼저 물어봐요. 아니라면 단일 에이전트로 충분해요.
에이전트를 늘리는 건 도구가 해줘요. 늘려도 되는 일인지 판단하는 건 여전히 사람 몫이고요.
여러분은 에이전트 몇 개까지 나란히 돌려보셨나요? 몇 개째에서 처음 꼬이기 시작했는지도 궁금하네요.